Jeśli planujesz AI poza etapem eksperymentów, sama liczba GPU nie wystarczy. Potrzebujesz jasnych kryteriów biznesowych, dobrego sizingu i gotowości operacyjnej.
Generatywna AI przestała być projektem „na później”. Jeśli odpowiadasz za IT, dane albo infrastrukturę, czujesz presję na szybkie wyniki, krótszy time-to-value i pełną kontrolę nad danymi. Właśnie w tym miejscu pojawia się pytanie o NVIDIA DGX.
Nie chodzi tylko o szybkie GPU. Chodzi o to, czy potrafisz zamienić pomysł na AI w środowisko produkcyjne, które działa stabilnie, jest zgodne z politykami bezpieczeństwa i nie rozjeżdża budżetu po trzech miesiącach.
Dlaczego NVIDIA DGX teraz ma znaczenie dla firm
Firmy coraz częściej przechodzą z prostych eksperymentów do modeli, które muszą obsłużyć realny ruch, prywatne dane i zespoły pracujące równolegle. Przy modelach GenAI nie wystarcza już pojedyncza karta w stacji roboczej ani doraźne użycie chmury bez kontroli kosztów.
Jeśli rozwijasz RAG, fine-tuning LLM albo inferencję dla wielu działów, szybko zderzasz się z trzema ograniczeniami: pamięcią GPU, przepustowością między GPU i przewidywalnością kosztów. NVIDIA DGX odpowiada właśnie na te trzy problemy, ale tylko wtedy, gdy wdrażasz go świadomie.
To nie jest zakup „na próbę”. To decyzja infrastrukturalna.
Czym jest NVIDIA DGX i z czego składa się platforma
NVIDIA DGX to rodzina zintegrowanych systemów obliczeniowych do AI, projektowanych pod trening, fine-tuning i inferencję modeli na poziomie enterprise. W praktyce mówimy o gotowej platformie, a nie tylko o serwerze z GPU.
W aktualnych architekturach referencyjnych spotkasz systemy klasy DGX B200, DGX H200 i DGX H100. W podejściu BasePOD pojedynczy węzeł obliczeniowy ma 8 GPU, a komunikacja między węzłami opiera się o NDR400 InfiniBand. W warstwie fabric używa się przełączników NVIDIA Quantum QM9700.
Rodzina systemów DGX i ekosystem oprogramowania
Dobrym przykładem jest DGX B200. To system przeznaczony do szerokiego zakresu obciążeń AI, od analityki po trening i inference. Według dokumentacji zawiera 8 GPU NVIDIA B200, łącznie 1440 GB pamięci GPU, 2 procesory Intel Xeon 8570 oraz 2 dyski NVMe M.2 1,92 TB w RAID 1.
Sama moc obliczeniowa to tylko połowa obrazu. Druga połowa to software stack, który w środowisku produkcyjnym decyduje o czasie wdrożenia i stabilności.
NVIDIA AI Enterprise dzieli się na dwie warstwy. Część aplikacyjna obejmuje między innymi NIM microservices, NeMo i biblioteki AI. Część infrastrukturalna obejmuje sterowniki GPU, Run:ai, MIG, operatory Kubernetes i Base Command Manager. Dla Ciebie oznacza to prostszy podział odpowiedzialności między zespół platformowy a zespół data science.
Kluczowe komponenty NVIDIA DGX: GPU, NVLink, storage i sieć
W systemach DGX ważne są cztery warstwy.
Po pierwsze GPU i pamięć GPU. To one wyznaczają, jaki model uruchomisz, z jakim batch size i przy jakiej długości kontekstu.
Po drugie połączenia między GPU, w tym NVLink. Przy większych modelach i treningu rozproszonym to one decydują, czy skalowanie ma sens, czy tylko dokładzasz koszt i czekasz na synchronizację.
Po trzecie sieć między węzłami. Jeśli wchodzisz w klaster multi-DGX, RDMA i InfiniBand przestają być dodatkiem, a stają się fundamentem.
Po czwarte storage. Jeśli dane i checkpointy nie nadążają za GPU, płacisz za bezczynność akceleratorów.
Dla kogo DGX dla firm ma sens biznesowy
NVIDIA DGX nie jest rozwiązaniem dla każdego. Ma sens tam, gdzie AI ma wejść do produkcji, a nie zostać demonstracją.
Najczęstsze kryteria wyglądają tak:
- Modele i skala: pracujesz z modelami od 7B wzwyż, planujesz fine-tuning, RAG na dużych zbiorach albo wiele równoległych eksperymentów
- Polityka danych: dane nie mogą opuszczać środowiska on-prem lub wymagają silnej kontroli retencji i dostępu
- Koszt chmury: miesięczne wydatki na GPU w chmurze są wysokie i trudne do przewidzenia przy rosnącej liczbie testów
- Wymogi branżowe: podlegasz regulacjom, audytom lub standardom bezpieczeństwa, które utrudniają swobodne użycie usług public cloud
- Zespół i tempo: masz data scientistów, MLOps i właścicieli procesów, którzy rzeczywiście wykorzystają platformę w trybie ciągłym
Jeśli GPU utilization w chmurze przez wiele tygodni przekracza 50 do 60 proc., a obciążenia są przewidywalne, on-prem zaczyna być mocnym kandydatem. Jeśli działasz skokowo, masz mały zespół i niestabilny backlog, chmura nadal może być rozsądniejsza.
Przykładowe use case’y dla NVIDIA DGX
Najwięcej sensu biznesowego widać tam, gdzie łączysz dane firmowe, niskie opóźnienia i powtarzalne użycie.
- RAG dla działów prawnych, serwisu i wsparcia
- Fine-tuning modeli 7B, 13B i 70B pod domenowe słownictwo
- Wizja komputerowa w produkcji, logistyce i retail
- Symulacje i obliczenia naukowe wspierane przez GPU
- Inference dla wielu zespołów na wspólnej platformie
- Trening własnych foundation models, jeśli masz skalę danych, budżet i uzasadnienie operacyjne
W praktyce wiele firm zaczyna od RAG i inferencji, potem przechodzi do fine-tuningu. Pełne trenowanie foundation models to już inna liga kosztów, danych i kompetencji.
Sizing i architektura referencyjna dla NVIDIA DGX
Zanim zamówisz sprzęt, policz nie tylko parametry modelu, ale też styl pracy zespołu. Jeden dział, jeden model i kilka eksperymentów tygodniowo to zupełnie inny profil niż centralna platforma AI dla całej organizacji.
Jak oszacować zasoby GPU, batch size i training tokens
Najpierw odpowiedz na pięć pytań: jaki model, jaka precyzja, jaki kontekst, ilu użytkowników jednocześnie i ile eksperymentów tygodniowo. Dopiero potem przechodź do liczby GPU.
Poniżej krótka tabela startowa.
Scenariusz | Punkt startowy | Typowe metryki |
RAG z modelem 7B do 8B, | 1 do 2 GPU wysokiej pamięci lub współdzielony DGX | latency 1,5 do 3 s, GPU util. |
Fine-tuning 13B, | 1 system DGX | trening od kilkunastu godzin |
Fine-tuning 70B, | 1 do 2 DGX zależnie od celu i czasu | wysoka presja na pamięć |
Trening rozproszony większych modeli | klaster multi-DGX z RDMA | ważna wydajność fabric |
Praktyczna reguła jest prosta: jeśli zależy Ci na czasie iteracji, licz nie tylko „czy model się mieści”, ale „ile eksperymentów wykonasz tygodniowo”. Często właśnie to, a nie sama pojemność pamięci, uzasadnia DGX dla firm.
Topologie NVIDIA DGX: pojedynczy system, multi-DGX, RDMA i InfiniBand
Pojedynczy DGX ma sens przy PoC, inferencji, RAG i fine-tuningu średniej skali. Daje prostsze wdrożenie i mniej punktów awarii.
Multi-DGX zaczyna mieć sens, gdy musisz skalować trening, uruchamiać wiele zespołów równolegle albo budujesz wewnętrzną platformę AI. Wtedy sieć przestaje być „połączeniem między serwerami”, a staje się zasobem produkcyjnym. Dla takich środowisk architektury referencyjne NVIDIA wskazują NDR400 InfiniBand.
Jeśli budujesz otoczenie dla DGX, często uzupełniasz je dodatkowymi serwerami opartymi o platformy ODM, na przykład Supermicro, MiTAC, ASUS, ASRock lub GIGABYTE, z procesorami Intel albo AMD oraz SSD Kioxia, Micron lub Samsung. To zwykle dotyczy warstwy storage, usług pomocniczych, rejestrów i narzędzi MLOps.
Storage i I/O dla pracy z modelami AI
Dla AI storage musi nadążać za GPU. To dotyczy zbiorów treningowych, embeddingów, checkpointów, cache i logów eksperymentów.
Przyjmij prosty podział. Lokalne NVMe służy na system, cache i szybkie dane robocze. NAS lub storage scale-out obsługuje zbiory współdzielone, checkpointy i dane zespołowe. Dobrą praktyką jest też lustro danych do odseparowanego obszaru, szczególnie jeśli uczysz na danych regulowanych.
Jeśli w treningu widzisz niskie GPU utilization mimo wolnych akceleratorów, najpierw sprawdź I/O. Bardzo często to nie GPU są problemem.
Wymagania środowiskowe i operacyjne dla DGX on-prem
To etap, który bywa pomijany, a potem zatrzymuje projekt na miesiąc.
Do planowania przyjmij budżet mocy liczony w wielu kilowatach na system tej klasy, zwykle około 10 do 15 kW na węzeł jako punkt odniesienia infrastrukturalnego. Dokładną wartość zawsze potwierdź dla wybranego modelu i konfiguracji. Potrzebujesz zasilania trójfazowego, najlepiej z redundancją A/B tam, gdzie polityka dostępności tego wymaga.
Drugi temat to chłodzenie i hałas. Taki sprzęt nie nadaje się do biura. Potrzebujesz racka, kontroli temperatury, monitoringu środowiskowego i realnego planu serwisowego.
Trzeci obszar to zarządzanie out-of-band. BMC, Redfish, kontrola zasilania, secure flash i bezpieczeństwo firmware nie są dodatkiem. W dokumentacji DGX to elementy podstawowe.
MLOps i software stack dla DGX w środowisku produkcyjnym
Jeśli chcesz wiedzieć, jak zacząć z DGX, odpowiedź brzmi: nie od kart katalogowych, tylko od ścieżki operacyjnej modelu od danych po inferencję.
NVIDIA AI Enterprise, NIM i Base Command
AI Enterprise daje Ci wspieraną warstwę oprogramowania dla środowiska enterprise. To ważne, bo skraca czas integracji, upraszcza utrzymanie i porządkuje odpowiedzialność za wersje sterowników, kontenerów i frameworków.
NIM microservices przyspieszają wdrażanie modeli do inferencji. Z perspektywy biznesu zyskujesz krótszy czas od PoC do API gotowego dla aplikacji. Base Command Manager upraszcza instalację i zarządzanie klastrami oraz środowiskiem użytkowników.
Kubernetes, Slurm, registry modeli i feature store
Kubernetes jest naturalnym wyborem dla inferencji, usług API i środowisk współdzielonych. Slurm bywa lepszy dla klasycznych jobów treningowych HPC i zadań batch. W wielu firmach oba światy działają obok siebie.
Potrzebujesz też rejestru modeli, kontroli wersji danych, artefaktów eksperymentów i feature store, jeśli pracujesz z danymi tablicowymi lub hybrydowymi pipeline’ami ML. Bez tego MLOps szybko zamieni się w ręczne kopiowanie kontenerów i checkpointów.
Observability: trening, inferencja i profilowanie GPU
Mierz przynajmniej cztery rzeczy: GPU utilization, czas eksperymentu, koszt per eksperyment i opóźnienie inferencji pod obciążeniem.
Dobrze działające środowisko produkcyjne ma alerty dla pamięci GPU, temperatur, błędów ECC, NVMe wear, kolejek jobów i anomalii w sieci RDMA. Jeśli tego nie masz, nie wiesz, czy platforma zarabia na siebie, czy stoi bezczynnie.
Bezpieczeństwo i zgodność przy wdrożeniu DGX dla firm
Przy AI on-prem odpowiadasz nie tylko za model, ale też za cały łańcuch dostępu do danych, obrazów kontenerowych i sekretów.
Podstawowy zestaw kontroli obejmuje segmentację sieci, RBAC, skanowanie obrazów, bezpieczne składowanie sekretów, odseparowaną sieć zarządzającą i pełny audyt zmian. Jeśli środowisko przetwarza dane osobowe, RODO wymaga odpowiednich środków technicznych i organizacyjnych chroniących integralność i poufność przetwarzania, a także ograniczenia retencji danych.
Dla części branż dochodzą normy ISO, wewnętrzne polityki bezpieczeństwa, wymagania klientów publicznych lub obronnych, a czasem identyfikacja podmiotów i łańcucha dostaw, na przykład w kontekście NCAGE. Już na etapie PoC ustal, jakie dane wolno użyć i jak długo możesz je przechowywać.
TCO i ROI dla NVIDIA DGX
Najwięcej błędów powstaje wtedy, gdy liczysz tylko cenę systemu. TCO obejmuje też energię, chłodzenie, licencje, sieć, storage, PeopleOps, monitoring i czas zespołu platformowego.
Przykład kalkulacyjny: jeśli po zsumowaniu CAPEX, energii, wsparcia i operacji wychodzi Ci 22 do 30 zł za efektywną GPU godzinę przy wykorzystaniu 60 do 70 proc., a chmura kosztuje 38 do 55 zł za porównywalną GPU godzinę on-demand, on-prem może obronić się szybciej, niż zakładasz. Jeśli jednak realne wykorzystanie spadnie do 20 proc., matematyka przestaje być korzystna.
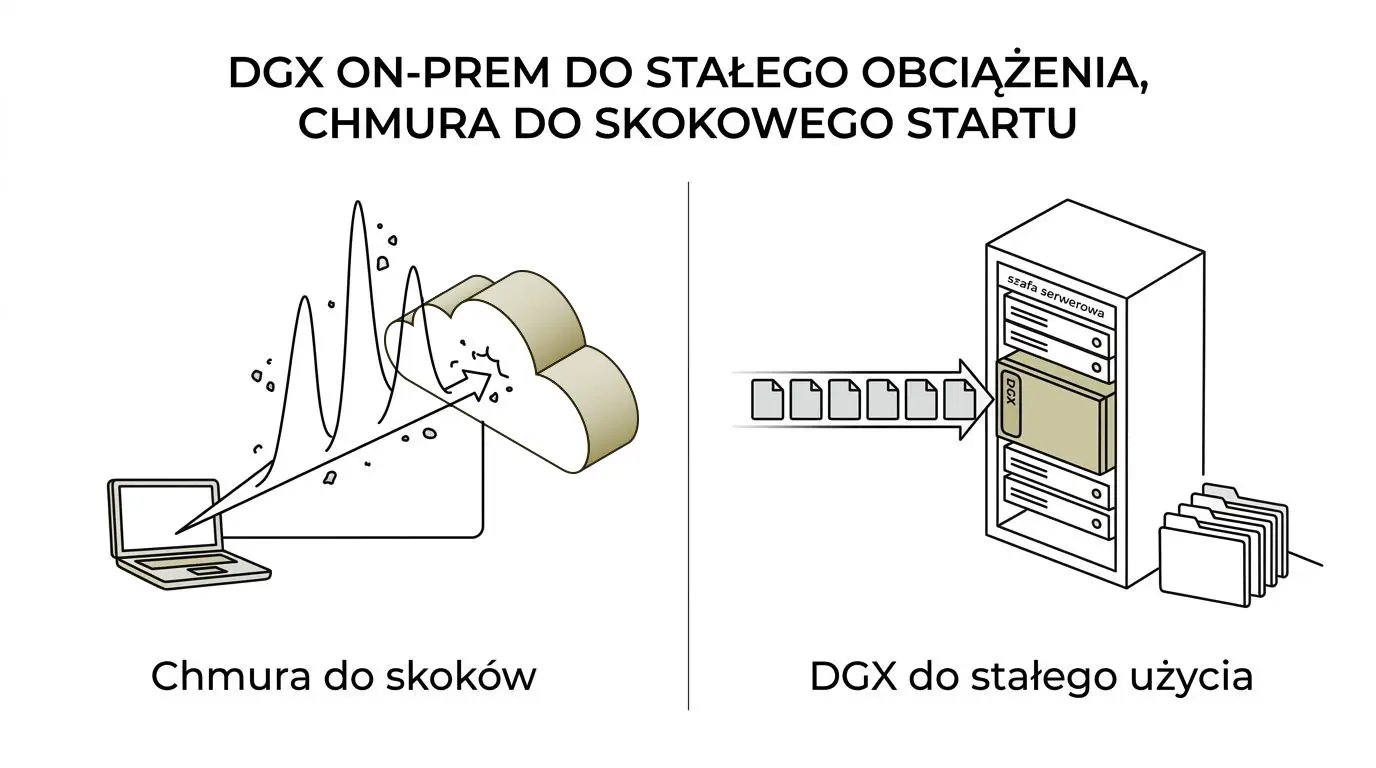
Krótka tabela pomaga uporządkować fakty.
Kryterium | DGX on-prem | Chmura GPU |
Dane wrażliwe | bardzo dobry wybór | zależne od polityk i regionów |
Obciążenie stałe | zwykle korzystne kosztowo | często droższe w długim okresie |
Start projektu | wolniejszy niż cloud | bardzo szybki |
Skalowanie skokowe | ograniczone zakupem | bardzo dobre |
Kontrola środowiska | pełna | częściowa |
On-prem wygrywa wtedy, gdy masz stały popyt na moc, dane regulowane i potrzebę przewidywalności. Chmura wygrywa przy krótkich eksperymentach, niestabilnym backlogu i małym zespole operacyjnym.
Jak zacząć z DGX: plan 90 dni
Tydzień 1 do 2: ocena dojrzałości, backlog i analiza danych
Na początku nie kupuj sprzętu. Zbierz backlog use case’ów, oceń jakość danych, policz miesięczne zużycie GPU w obecnych eksperymentach i sprawdź wymagania compliance.
Efekt tego etapu powinien być prosty: 2 do 4 use case’y, które da się zmierzyć, plus decyzja, które dane wolno wpuścić do PoC.
Tydzień 3 do 6: PoC na wypożyczonym systemie lub w labie partnera
PoC powinien mieć metryki sukcesu, a nie tylko demo. Mierz czas trenowania, latency inferencji, precision lub answer quality, koszt eksperymentu, wykorzystanie GPU i czas pracy zespołu.
Dobry PoC odpowiada na trzy pytania: czy model daje wartość, czy platforma jest stabilna i czy zespół potrafi ją obsługiwać.
Tydzień 7 do 12: decyzja build lub buy i przygotowanie landing zone
Na tym etapie podejmujesz decyzję o architekturze docelowej. Jedno urządzenie, klaster multi-DGX albo model hybrydowy z częścią pracy w chmurze.
Równolegle przygotuj data center, zasilanie, sieć zarządzającą, polityki RBAC, registry obrazów, monitoring, backup artefaktów i ścieżkę wdrożeniową dla MLOps. Jeśli zrobisz to po dostawie sprzętu, projekt straci tempo.
Najczęstsze pułapki przy wdrożeniu NVIDIA DGX
Błędy zwykle nie wynikają z wyboru złego GPU. Wynikają z pominięcia warstwy operacyjnej.
- Za mało danych produkcyjnych: PoC na czystym zbiorze działa, a środowisko realne psuje jakość odpowiedzi
- Brak ownership: data science chce GPU, ale nikt nie odpowiada za platformę, bezpieczeństwo i koszt
- Zły storage: drogie akceleratory czekają na dane i checkpointy
- Pominięcie MLOps: model działa w notebooku, ale nie ma ścieżki do wersjonowania i wdrożenia
- Niedoszacowanie energii i chłodzenia: sprzęt jest gotowy, rack nie
- Niejasny ROI: projekt technicznie się broni, ale nie ma biznesowego sponsora i metryk sukcesu
Mini case studies dla średnich i dużych firm
Produkcja: wizja komputerowa i analiza dokumentacji serwisowej
Przykład: firma przemysłowa łączy wykrywanie defektów z RAG nad instrukcjami serwisowymi. W PoC używa 1 systemu DGX do treningu modeli wizji i inferencji dla asystenta technicznego.
Po 6 tygodniach uzyskuje spadek czasu diagnozy o 32 proc., precision@5* w wyszukiwaniu dokumentów rośnie o 19 punktów procentowych, a średnie opóźnienie odpowiedzi utrzymuje się poniżej 2,4 s.
*Precision@5 to wskaźnik jakości wyników, najczęściej dla wyszukiwarki, RAG albo rekomendacji. Liczy, ile z pierwszych 5 wyników było trafnych. Przykład, jeśli 4 z top 5 wyników są poprawne, to Precision@5 = 0,8, czyli 80%.
Finanse i ubezpieczenia: prywatny RAG z polityką danych on-prem
Przykład: organizacja nie chce wysyłać danych klienta do zewnętrznych usług. Buduje DGX dla firm jako platformę do inferencji i kontrolowanego fine-tuningu.
PoC obejmuje 12 mln stron dokumentów, 180 użytkowników testowych i model 8B. Efekt to skrócenie czasu przygotowania odpowiedzi dla analityka z 18 minut do 4 minut oraz koszt eksperymentu niższy o 27 proc. względem wcześniejszego użycia chmury przy podobnym wolumenie.
Media i postprodukcja: transkrypcja, tagowanie i wyszukiwanie materiałów
Przykład: studio przetwarza duże zbiory wideo i audio. DGX obsługuje inferencję dla transkrypcji, embeddingów i klasyfikacji treści.
Przy stałym obciążeniu 14 godzin dziennie organizacja utrzymuje GPU utilization na poziomie 58 do 68 proc. To zakres, przy którym model on-prem zaczyna być finansowo racjonalny.
FAQ o NVIDIA DGX dla firm
Czy NVIDIA DGX ma sens już przy modelach 7B?
Tak, jeśli nie chodzi tylko o jeden model uruchamiany okazjonalnie. Sens pojawia się wtedy, gdy masz wiele eksperymentów, prywatne dane, kilka zespołów albo potrzebę szybkiego przejścia do produkcji.
Czy lepiej zacząć od chmury czy od on-prem?
Jeśli nie znasz profilu obciążenia, zacznij od PoC w kontrolowanym środowisku testowym. Jeśli dane są wrażliwe i już dziś masz stałe użycie GPU, on-prem może być szybszą drogą do stabilnej platformy niż dalsze eksperymenty w chmurze.
Czy jeden DGX wystarczy na start?
Często tak. Jeden system wystarcza do RAG, inferencji i części scenariuszy fine-tuningowych. Klaster multi-DGX ma sens dopiero wtedy, gdy masz uzasadnioną potrzebę skalowania lub kilka zespołów konkurujących o zasoby.
Jakie metryki sukcesu ustalić w PoC?
Mierz jakość odpowiedzi, latency, koszt eksperymentu, czas trenowania, GPU utilization i czas potrzebny na wdrożenie modelu do środowiska testowego. Bez tych danych ROI będzie intuicją, nie decyzją.
Czy MLOps jest konieczny od początku?
Tak, choć na poziomie proporcjonalnym do skali. Nawet mały PoC powinien mieć wersjonowanie danych, artefaktów i modeli. Inaczej nie odtworzysz wyników.
Źródła i dalsza lektura
NVIDIA DGX BasePOD Reference Architecture. Oficjalna architektura referencyjna dla środowisk z DGX B200, DGX H200 i DGX H100 oraz siecią NDR400 InfiniBand.
NVIDIA DGX B200 User Guide. Dokumentacja systemu, w tym skład platformy, BMC, Redfish, power capping, secure flash i elementy bezpieczeństwa firmware.
NVIDIA AI Enterprise Documentation. Opis warstwy Application Development i Infrastructure Management, wraz z NIM, NeMo, Run:ai, MIG i operatorami Kubernetes.
NVIDIA NIM Documentation. Materiały o microservices do wdrażania modeli z runtime gotowym do użycia produkcyjnego.
NVIDIA Base Command Manager Documentation. Zasady instalacji, konfiguracji i zarządzania klastrami bare metal oraz środowiskiem użytkowników.
EUR-Lex, GDPR. Oficjalny tekst RODO, istotny przy planowaniu retencji danych, integralności i poufności przetwarzania.
Dokumentacje wybranych narzędzi MLOps i orkiestracji, w tym Kubernetes, Slurm i rejestrów artefaktów. Przydadzą się na etapie projektu operacyjnego.
Co zrobić jutro
Jeśli chcesz ocenić opłacalność i przygotować PoC, skontaktuj się z zespołem, który potrafi połączyć infrastrukturę, MLOps i wymagania data center w jeden plan działania.
- Zbierz 3 najważniejsze use case’y AI i dopisz do nich metryki sukcesu.
- Sprawdź, ile dziś realnie wydajesz na GPU w chmurze i ile wynosi wykorzystanie zasobów.
- Oceń politykę danych: co może trafić do PoC, a co musi zostać on-prem.
- Zweryfikuj gotowość data center: zasilanie, chłodzenie, rack, sieć zarządzająca, monitoring.
- Ustal, czy potrzebujesz jednego systemu DGX, czy ścieżki do klastra multi-DGX w kolejnym etapie.
Nvidia DGX w firmie: od PoC do wdrożenia